深層学習(Deep learning)は、核融合・プラズマ物理学の手法。多層ニューラルネットワークにより実験・シミュレーションデータから非線形関係を学習し、プラズマの不安定性予測や物理量の高速推定を可能にする。実時間制御や大規模データ解析への応用が進み、第一原理計算の代替モデルとしても用いられる。この用語集が追う論文のうち、タイトルにこの主題が現れるものは51本ある。比重が最も大きいのは直近の2025–2029年で、その期間に発表された論文の0.40%を占める。この用語集がこの主題を最初に拾うのは2015年以降で、それ以前の収録論文には現れない。
解説
深層学習(deep learning)とは、多層ニューラルネットワークを大量のデータから訓練し、入力と出力の間の複雑な対応関係を学習させる手法である。核融合プラズマ研究では、実験データの膨大さと第一原理シミュレーションの計算コストの高さという二つの事情から、2019年頃以降に急速に普及した。代表的な応用は、ディスラプション(プラズマの突然の終息)の予測、乱流輸送や平衡再構成の代理モデル(surrogate model)、診断データの逆問題解析である。図は、輸送計算コードTGLFをニューラルネットワークで置き換える代理モデルTGLF-WINNの構成を示したものであり、入力パラメータを波数ごとの予測枝に分岐させ、各枝が個別の輸束を予測した後、それらを総和して最終的な輸束予測を得るという、この分野で典型的なネットワーク設計が見て取れる。
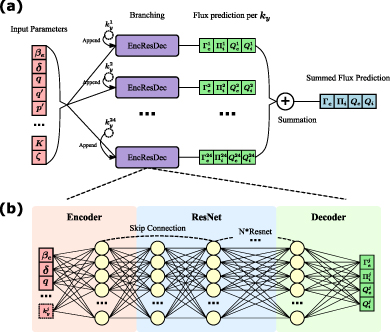
fig.1 TGLF-WINN: data-efficient deep learning surrogate for turbulent transport modeling in fusion (2026) · CC BY 4.0
Overview of TGLF-WINN architecture. (a) TGLF-WINN takes 31 input features (the same as TGLF-NN) and splits into 24 branches. Each branch produces 4 flux predictions corresponding to a specific wavenumber. These fluxes are then summed to yield the final fluxes. (b) The Encoder-ResNet-Decoder module shared by all prediction branches.
深層学習の仕組み:ネットワーク、訓練、アーキテクチャ
深層学習の基本要素は、入力層と出力層の間に多数の「隠れ層」を挟んだニューラルネットワークである。各層の各ニューロンは、前層の値の重み付き和を取り、非線形の活性化関数を通して次層へ渡す。重み(パラメータ)は、訓練データに対する予測誤差を表す損失関数を、誤差逆伝播法と勾配降下法で最小化することにより決められる。層を深くするほど入力の階層的な特徴を自動的に獲得できるが、その一方で、必要な訓練データ量が増え、モデルの内部で何が判断根拠になっているかが分かりにくくなるという代償を伴う。
用途に応じて複数の標準的なアーキテクチャが使い分けられる。空間的な画像やスペクトログラムを扱うには畳み込みニューラルネットワーク(CNN)が、時系列信号を扱うには再帰型ネットワーク(LSTMなど)が適する。近年はトランスフォーマ(Transformer)も用いられる。核融合への応用では、磁気揺らぎのスペクトログラムからのMHDモード自動識別にCNN、ディスラプション予測に時系列ネットワーク、輸送係数の回帰に全結合層を主体とするネットワークが使われる、というように、データの構造がアーキテクチャの選択をほぼ決める。
もう一つの重要な設計判断は、何を入力とし何を予測させるかである。生の診断信号をそのまま入力する場合もあれば、プラズマ電流や形状パラメータ、モード回転数など、物理的に意味のある特徴量を前段で抽出してから入力する場合もある。後者では、特徴抽出器を共有しつつ、複数の出力頭部(例えば不安定イベントの分類とディスラプション予測)を並列に持たせるマルチタスク構成がしばしば採られる。図はその一例で、共有の特徴抽出器の上流に、イベント分類を行う枝とディスラプション分類を行う枝が分岐した構造を示す。このように一つのネットワークに複数の役割を持たせることで、事象の連鎖という文脈情報を予測に反映できる。
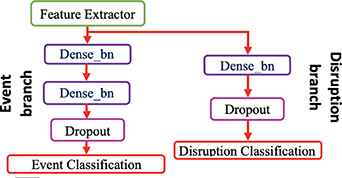
fig.5 Integrated deep learning framework for unstable event identification and disruption prediction of tokamak plasmas (2023) · CC BY 4.0
The architecture of the integrated deep learning framework. The detailed structure of the feature extractor is given in figure 1.
ディスラプション予測と不安定性の同定
トカマクにおけるディスラプションは、大型MHD不安定性の成長や不純物による強い放射を原因として、閉じ込められた磁気エネルギーと熱エネルギーを極めて短時間で失う現象であり、次世代装置では装置を傷つけうる最大級のリスクである。第一原理からの予測は原因の多様さゆえに困難で、長年の運転で蓄積された大量の放電データを用いるデータ駆動型の手法が主流となった。深層学習を用いた予測器は、磁気探測コイルや干渉計など多数の診断信号の時系列を入力とし、一定時間内にディスラプションが起こるか否か、あるいは起こるまでの残り時間を予測する。複数装置のデータで訓練された予測器が装置をまたいでも一定の性能を保ちうることが示され、この分野の研究を大きく後押しした。
実運用では「いつ警報を出すか」というトレードオフが本質である。警報閾値を甘くすれば誤警報が増えて運転を妨げ、厳しくすれば見逃しが増える。性能は通常、偽陽性率を固定したもとで警報からディスラプションまでの余裕時間(warning time)の分布で評価される。図は、不安定イベントの同定情報を予測器に組み込んだ場合とそうでない場合の余裕時間の累積分布を比較したものであり、イベント情報を用いることで平均余裕時間が約1.2秒から約1.3秒へ延び、50ミリ秒閾値以上の余裕を持って検出される割合が上昇することが読み取れる。余裕時間が長いほど、ガス注入やペレット注入といった緩和策、あるいは密度を下げる・プラズマ電流を下げるといった回避操作を実際に間に合わせて行える。
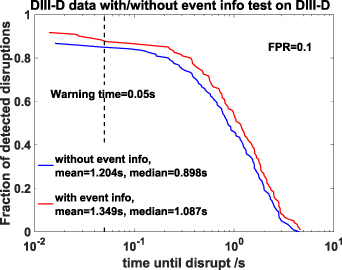
fig.8 Integrated deep learning framework for unstable event identification and disruption prediction of tokamak plasmas (2023) · CC BY 4.0
The cumulative distributions of warning time from DIII-D test sets returned by integrated deep learning model (using event information, red) and baseline disruption predictor (without event information, blue). The vertical dashed line shows the 50 ms warning time threshold.
深層学習予測器の弱点は、ディスラプションに至る物理的な前兆(ティアリングモードのロック、放射崩壊、ELMなど)を明示的に同定しない点にあった。そこで近年は、事象検出器とディスラプション予測器を統合した枠組みが提案され、最終的なディスラプションだけでなく、それに至る事象の連鎖そのものを分類する。これにより予測の解釈可能性が増し、どの作動手段を使うべきかの判断にも結びつく。また、事象情報の併用は異なる装置間での予測器の移植性を高めることも示されている。
新装置への適用は別の難題を突きつける。新設トカマクでは放電数が少なく、装置の改造とともにデータの分布が変化し続けるため、長年運転した装置で培った手法をそのまま当てはめられない。新装置HL-3では、データ拡張や段階的な再訓練など、データ量と分布ドリフトの両方の制約に対処する手法が開発され、72回のディスラプション放電と240回の非ディスラプション放電からなる試験キャンペーンでROC曲線下面積0.940の予測性能が達成された。この種の経験は、運転初期から安全対策を機能させる上で不可欠である。
シミュレーションと輸送の代理モデル
核融合の全体装置シミュレーションでは、プラズマ断面の輸送係数を各時間刻みで何度も評価する必要がある。最も忠実なジャイロキネティックシミュレーションは5次元の位相空間を解くため1回の評価にスーパーコンピュータで数時間を要し、結合したワークフローには使えない。準線形理論に基づくTGLFのような縮約モデルは1回あたり数秒まで速くしたが、それでも全体装置シミュレーションには重い。ここで深層学習の登場である。TGLFの出力をニューラルネットワークで学習すれば、評価時間をマイクロ秒まで短縮できる。
代理モデルの成否は、訓練データの作り方に大きく依存する。輸束の大きさがパラメータ空間の狭い領域で桁違いに変わるため、広い範囲を均しの良いデータで覆うには膨大なサンプルが必要になる。これに対して、波数ごとの輸束を正則化項として学習に組み込み、ベイズ能動学習で情報利得の大きいデータ点だけを追加生成する手法では、全データの4分の1程度の訓練データで同等の精度が得られることが示された。データ生成コストが支配的なジャイロキネティックシミュレーションへの拡張において、この種のデータ効率化は決定的に重要である。
輸送以外の代理モデルも進んでいる。中性子トロイダル粘性トルクの予測、低温度プラズマ化学の常微分方程式系の高速求解、マイクロ波とプラズマの相互作用の2次元シミュレーションの高速化など、第一原理計算のボトルネック部分を学習済みモデルで置き換える試みが複数のサブ分野で行われている。いずれも共通するのは、物理モデルを捨てるのではなく、その中で最も計算コストの高い評価関数だけを学習済みネットワークに差し替えるという発想である。
診断の逆問題とプロファイル再構成
トカマクの多くの診断は、視線に沿った積分値を測る。ソフトX線トモグラフィーやボロメータは視線積分された放射強度を、干渉計はレーザー経路に沿った密度積分を与える。そこから2次元分布やプロファイルを復元する逆問題は、物理モデルに基づく手法では高精度だが計算が重く、実時間制御には向かない。深層学習では、物理コードが生成した訓練データを用いて、測定値から直接分布を予測するネットワークを訓練する。ソフトX線画像の再構成、赤外線画像からの熱負荷逆解析、燃料氷層表面の溝の定量評価など、積分測定や間接測定からの復元全般に応用が広がっている。
平衡再構成における安全係数qプロファイルの学習による復元は、この方向性をよく示す例である。qプロファイルは磁力線のピッチ角を定める重要な量で、従来は磁気測定のみの再構成では軸付近の精度が不足し、運動ストーク効果(MSE)測定を制約に加えて初めて信頼できる値が得られていた。しかしMSEは特定の中性粒子線ビームに依存するため、使えない放電が少なからず存在する。そこで、MSEなしで得られる診断信号と実時間平衡再構成の結果を入力とし、MSE制約付きで再構成されたqプロファイルを教師として学習したネットワークが構築された。約1万2千件の再構成データで訓練されたこのモデルは、MSEなしの従来再構成を上回るqプロファイルを与え、推論時間も実時間制御系に適合する。これは、物理モデルでは明示的な制約として表現しにくい測定情報の相関を、学習によって暗黙的に回収できることを示した例である。
物理情報を組み込んだ学習と実時間運用
純粋にデータ駆動的なモデルには二つの構造的な弱点がある。第一に、訓練データの範囲外では予測が信頼できなくなること、第二に、入出力の対応は学習できても物理的な解釈が得られにくいことである。これに対し、物理法則を損失関数やネットワーク構造に組み込む物理情報ニューラルネットワーク(PINN)の考え方が導入されている。診断の逆問題では、視線積分という測系の原理を応答行列として損失関数に組み込むことで、単なるデータ対データの写像ではなく、診断系の物理を踏まえた反転が可能になる。また、ランナウェイ電子の動力学に物理制約を課した学習、自己発光X線画像のノイズ除去に物理情報を用いた枠組みなど、保存則や支配方程式を学習の正則化として使う試みが進んでいる。物理制約は、データが少ない領域での外挿の挙動を安定させ、予測の解釈可能性を高めるという二重の利点を持つ。
実験装置でこれらのモデルを実際に役立てるには、実時間性とデータ環境の変化への耐性が不可欠である。制御系に組み込むには、推論をミリ秒以下で行う必要があり、GPU上での推論パイプラインやFPGAへの実装が研究されている。また、装置の改造や運転領域の拡張に伴い入力データの分布がずれる(ドリフトする)ため、訓練時のデータだけでは長期にわたって性能を保証できない。新装置でのディスラプション予測の経験が示すように、再訓練の戦略やデータの継続的な追加を含めた運用設計が、深層学習を実験の日常道具として定着させる鍵となっている。
この解説が根拠にした論文から
- Integrated deep learning framework for unstable event identification and disruption prediction of tokamak plasmasNuclear Fusion 2023
- Reconstruction of tokamak plasma safety factor profile using deep learningNuclear Fusion 2023
- Implementing deep learning-based disruption prediction in a drifting data environment of new tokamak: HL-3Nuclear Fusion 2025
- Physics-informed deep learning model for line-integral diagnostics across fusion devicesNuclear Fusion 2025
- TGLF-WINN: data-efficient deep learning surrogate for turbulent transport modeling in fusionNuclear Fusion 2026
この解説は役に立ちましたか?
推移
研究の変遷
2015–202651本 · 0.20%
トカマク実機応用への急拡大
この時期、深層学習はプラズマ disruption 予測や安全係数再構成など、トカマク診断・制御の実問題に応用され始める。同時に Magnetohydrodynamics や Inertial confinement fusion などの基礎理論とも結びつき、east, jet, asdex-upgrade, kstar といった各装置のデータ解析に用いられた。代表的な論文として、2021年の「Deep learning based surrogate models for first-principles global simulations of fusion plasmas」や、2023年の「Integrated deep learning framework for unstable event identification and disruption prediction of tokamak plasmas」が挙げられる。
同時に語られた主題プラズマディスラプション、ディスラプション予測、電磁流体力学、慣性核融合、X線トモグラフィー、軟X線
この時代の論文から
- Deep learning based surrogate models for first-principles global simulations of fusion plasmasNuclear Fusion 2021
- Integrated deep learning framework for unstable event identification and disruption prediction of tokamak plasmasNuclear Fusion 2023
- Corrigendum: Hybrid deep learning architecture for general disruption prediction across tokamaks (2021 Nucl. Fusion61 026007)Nuclear Fusion 2021
- Reconstruction of tokamak plasma safety factor profile using deep learningNuclear Fusion 2023
よく登場する装置
この数字の作り方
- 数え方 —
- 同じものが別の名前で書かれていてもまとめて数えている。綴りが変わった時期に推移が動いて見える、ということは起きない
- 割合 —
- その時代の収録論文全体に占める比率。コーパスは1970年代より2010年代のほうが9倍大きいため、本数のままではほとんどの主題が右肩上がりに見えてしまう
- 記述 —
- その時代の論文・共起する主題・登場する装置だけを根拠にAIが書いている
- 冒頭の定義 —
- 用語そのものの説明だけは、論文26本の要旨を読ませたうえでAIの分野知識で書かせている。ここだけは収録論文に書かれていることの要約ではない
- 解説 —
- では、5本の論文(うち全文5本)と3枚の図版を読ませたうえでAIが書いている
- 範囲 —
- 収録は6誌に限られる。ここで減っていることは、分野がその取り組みをやめたことを意味しない